发展史
主线讲「怎么用」;本页讲「怎么长成今天这样」。可在走完 主线 后当故事书补读。
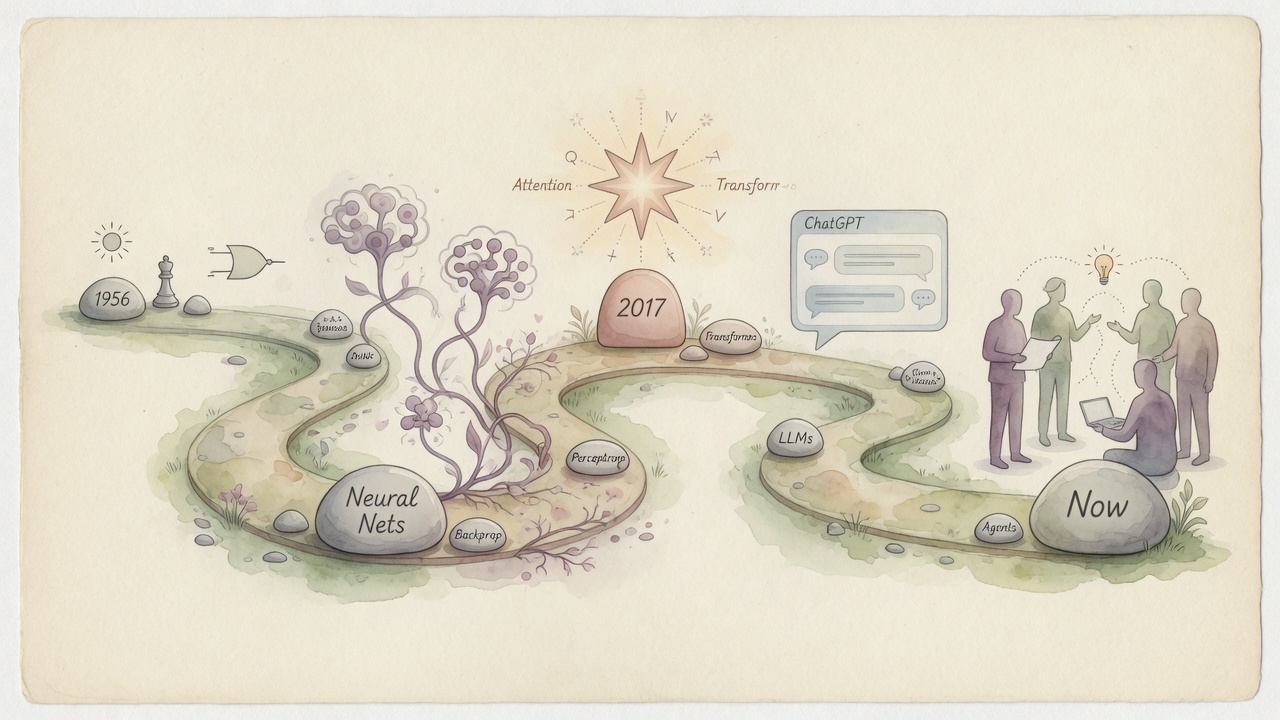
小白怎么读时间线
不必背年份。每段只抓三句:当时卡在哪 → 出现了什么办法 → 和今天的你有什么关系。 读完回到 通识分层,零件会更好懂。
想把 AI 放回更长的生产力周期,并从资本、企业收入和产业变革判断机会,可继续读 生产力大迁徙:从蒸汽机到 AI Agent。
图灵:机器能思考吗?
图灵提出用对话测试来讨论「机器是否智能」——重点是把问题说清楚,不是马上做出 ChatGPT。
「人工智能」成为学科
达特茅斯会议正式提出 Artificial Intelligence。当时极乐观,以为很快能做出通用智能,也为后来的期望落空埋下伏笔。
专家系统:把老师傅写成 if-else
主流想法:智能 = 知识 + 逻辑规则。在窄领域(如某些诊断、配置)有用,但世界开放、例外太多时,规则维护崩溃。
让电脑在专业领域按专家经验做判断。
公司里的「审批规则引擎」「固定流程机器人」仍是规则思想的亲戚。
规则适合「明确、少例外」;开放对话与模糊任务,才轮到 LLM。
期望落空 → 经费与热度下降
当承诺的通用智能迟迟不来,资助收缩。寒冬不是「AI 死了」,而是叙事跑太快后的纠正。
从写规则 → 从数据里学规律
垃圾邮件、推荐、风控等开始靠统计学习:喂例子,让模型自己找模式,而不是穷举规则。
深度网络 + GPU:看图听声变强
图像识别、语音识别大幅进步。大数据与算力成为燃料;很多特征不必人工设计。
Transformer:现代大模型的骨架
《Attention Is All You Need》提出的架构,让模型更擅长抓住长文本中的关系,也更适合大规模并行训练。之后的 GPT、BERT 等几乎都站在它上面。 论文:arXiv:1706.03762
旧序列模型难并行、难抓好全局依赖;Transformer 改善了这些。
没有它,很难有今天又快又强的对话模型。
听到 Transformer,知道是「现代 LLM 的底盘」即可,不必会推公式。
先海量自学,再微调上岗
模型先在广义语料上学会语言与世界知识,再针对任务微调。规模变大后,出现「给几个例子就会做」的能力。
检索增强:给模型外挂「可更新书架」
只靠训练知识会过时、不知你的内部文档。RAG 先检索再生成,成为企业知识问答的主流套路。
ChatGPT:人人可用的对话助手
指令微调与人类反馈对齐,让模型更「听得懂吩咐」。AI 从实验室和开发者工具,变成亿级用户的日常入口。
从「补全文字」变成「像助手一样对话协作」。
写作、学习、编程、翻译的门槛骤降;同时幻觉与隐私问题进入日常生活。
把它当初级同事:任务要写清,产出要检查,隐私要脱敏。
工具调用 · 开源模型 · Agent 框架井喷
模型开始稳定调用外部工具;开源权重降低门槛;LangGraph、LlamaIndex、CrewAI、Dify 等让「编排流程/智能体」成为工程问题。国内大模型与应用同步爆发。
用一张表记住「时代 → 你多了什么」
| 时代 | 核心能力 | 普通人得到什么 |
|---|---|---|
| 规则 / 专家系统 | 固定逻辑 | 窄场景自动判断(流程、风控规则) |
| 机器学习 | 从数据预测 | 推荐、反垃圾、信用评分 |
| 深度学习 | 感知(视听) | 语音输入、影像识别、翻译 |
| 大模型对话 | 通用语言协作 | 写作、学习、编程助手人人可用 |
| RAG + 工具 + Agent | 有据回答 + 代办 | 基于你的文档问答、自动多步任务 |
读史结论:今天的热词很少是突然发明的魔法,而是「模型变强后,把检索、工具、记忆、流程重新组装」。 你要学的是这套组装逻辑——也就是下一页的通识分层。